Por qué la IA patina al traducir nombres propios
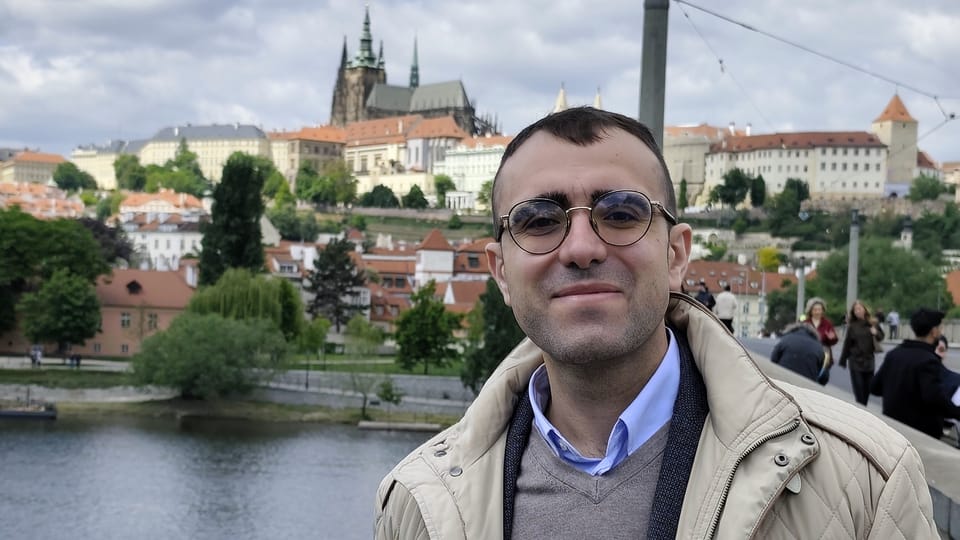
Los nombres propios parecen fáciles de traducir, pero cada caso es tan específico que las IA de traducción sufren con ellos. ¿Por qué decimos Castillo de Praga, si no parece un castillo? Fernando Sánchez Rodas, traductólogo español en la Universidad Palacký de Olomouc, está llevando a cabo una investigación sobre este tema. Con él hemos hablado, además, de los retos y las debilidades de la traducción automática.
Tenemos con nosotros a Fernando Sánchez Rodas, investigador español en la cátedra de lenguas romances de la Universidad Palacky de Ołomouc. Fernando centra su investigación en la traducción automática mediante IA generativa, y especialmente en la traducción (o no traducción) de nombres propios en el ámbito institucional y turístico. Hola Fernando. Muchas gracias por estar con nosotros.
Hola, Carlos, encantado de estar con vosotros y de que me hayáis concedido esta entrevista.

El tema de tu investigación es la traducción automática de nombres propios. A primera vista debería ser un asunto sencillo, ¿no? Uno se lo puede imaginar como que bueno que pues en una nueva persona es igual en diferentes lenguas. ¿Con qué complicaciones se encuentran los traductores humanos, o la IA, a la hora de traducir el nombre de, por ejemplo, un instituto, una montaña o un castillo.
Pues me alegra que comentes que debería ser un asunto sencillo a primera vista, porque, efectivamente, lo es solo a primera vista. La traducción de los nombres propios es un asunto fascinante y difícil. Es muy casuístico, es decir, va a depender de la manera en la que se dice cada nombre, depende casi individualmente de cada uno de ellos. Se cruzan muchos factores que contribuyen a esto. Depende, por supuesto, de la lengua de origen y la lengua de partida, la que se traduzca, va a depender también del tipo de nombre. Si es un nombre de persona, nombre de lugar o de institución. Y también de la función del texto y del tipo de texto, y muy importante es también el valor o connotación que represente ese nombre en la comunidad de origen.
Podemos resumirlo diciendo que como los nombres propios hacen referencia a realidades extralingüísticas muy concretas, muy únicas, la traducción de cada nombre es un mundo en sí. Y esa dependencia del contexto tan propia, la de la redundancia, es lo que lo hace tan difícil de solucionar por los humanos y más aún por la lA.
Hay que tener en cuenta la tradición que hay a la hora de traducir ciertos nombres, que a lo mejor puede ser diferente en diferentes países. Se me está ocurriendo que efectivamente, han mencionado antes el ejemplo de los castillos, podemos decir atracciones turísticas. Por ejemplo, del Pražský Hrad, de lo que tradicionalmente en español se conoce como como el Castillo de Praga. Pues quizás si introdujéramos un texto en checo con ese con ese nombre en una IA que estuviera más despistada, digamos, o que estuviera peor entrenada, nos podría generar una traducción que no fuera esa, sino que fuera quizá el Palacio de Praga o la Fortaleza de Praga, porque también es cierto que, a primera vista, el estilo arquitectónico del edificio tampoco casa cien por cien con la idea de un castillo en España, ¿no? Que es más tipo edad media. Sin embargo, la traducción que nosotros aceptamos como correcta, que no nos suena extraña, es Castillo de Praga, ¿por qué?

Porque hay una tradición humana, una convención aceptada de cómo se ha traducido a lo largo de los años, incluso de los siglos, ese ese monumento. Y algo distinto nos sonaría forzado o incluso no humano.
En Radio Praga luchamos constantemente con este tipo de traducciones, porque tenemos que traducir instituciones o lugares que tienen poca tradición de traducción al español. ¿Hay alguna directriz o una especie de guía? ¿Es más importante la literalidad, por ejemplo, al traducir, o que suene natural en la lengua de destino? ¿Qué consejos nos podrías dar?
Bueno, pues como decía anteriormente es que depende enormemente de esos factores contextuales. Del tipo de texto, para qué estamos traduciendo. Por ejemplo, una cuestión en la que Radio Praga también ha tenido ha tenido un papel en mi proyecto actual ha sido la traducción de los nombres de partidos políticos del checo al español.

Porque son una serie de instituciones que no tienen una traducción tan asentada en español, y en ese tipo de ejemplos, yo diría que la tendencia sí sería en nombre de partidos a buscar alguna traducción ya realizada por algún humano para tenerla como referencia de cara a corregir la traducción automática.
Pero claro, ¿qué es lo que ocurre? ¿Y por qué decía que Radio Praga estaba conectada en este caso? Porque claro, el corpus, es decir, el conjunto de traducciones que tenemos hechas por humanos de esos partidos es muy pequeño. Entonces, yo, para para evaluar esas traducciones, he tomado como referencia algunos de vuestros artículos en los que sí había equivalentes al español para de partidos como ANO, SPD, etc.
Entonces, tu investigación debería facilitar esto, pero también a las inteligencias artificiales para mantener un raccord y una coherencia a la hora de traducir siempre de la misma forma el mismo nombre. ¿A qué te estás dedicando exactamente ahora mismo? ¿En qué estás trabajando? ¿En qué dirección va tu investigación?
Actualmente yo estoy trabajando con la evaluación de la calidad de la traducción generada por herramientas de IA generativa, más concretamente por Chat GPT. Estamos utilizando tres pares de idiomas, todos hacia el español. Inglés-español, alemán-español y checo-español, y estamos utilizando como texto de partida textos parlamentarios, es decir, discursos del Parlamento, por ejemplo, el Parlamento checo o del Parlamento austriaco, para el caso del checo y el alemán.

Se trataría de otorgar una puntuación a esas traducciones mediante unas métrica, digamos, unas barras de medir que ya existen, están hechas por expertos y están estandarizadas para determinar de una manera lo más científicamente posible que esa traducción es buena, es aceptable o no. Desde el punto de vista humano.
Esta investigación, o este proyecto, está específicamente centrado en los nombres propios, como unidades, como ya estaba diciendo antes, muy sujetas a ese contexto humano individual, y por lo tanto más propensas a errores por parte del traductor automático.
Y a la hora de traducir una inteligencia artificial generativa como ChatGPT, ¿tiene más problemas del checo al español o del inglés a español? Es decir, el checo, al tener un corpus en comparativamente menor, ¿tiene más problemas la IA a la hora de trabajar este tipo de traducciones?

Sí, siguen saliendo estudios al respecto, pero podemos decir que, en líneas generales, sí. Podemos hablar de lo que lo que llamamos los pares anglocéntricos de lenguas, o podemos decir que la tecnología automática es en general anglocentrista, ¿no? Es decir, aquellos pares que incluyen inglés y además lenguas mayoritarias, como por ejemplo, el español.
Inglés-español o inglés-francés, inglés-portugués, etc., y al contrario, van a tener normalmente mejores resultados demostrables que los pares minoritarios como checo-inglés, y mucho más si se trata de pares que no incluyen en el inglés, lo que llamaríamos no anglocéntricos, como el par checo-español.
Esto ocurre de una manera más observable en los traductores automáticos tradicionales, como Deepl o Google Translate., que son más conocidos. Pero a la hora de traducir mediante IA generativa, por ejemplo, mediante ChatGPT, un texto, también deberíamos tener algo de cuidado, porque la realidad es que los sistemas como ChatGPT están muy entrenados de base con una gran cantidad de textos monolingües en inglés.

Ya que tenemos con nosotros a un experto en traducción por IA, ¿qué nos puedes decir de la situación actual de la traducción? Todos sabemos que la profesión de traductor se ve amenazada. Las traducciones por IA generativa cada vez son más frecuentes. ¿Cuál es el futuro de del traductor? ¿Cómo ves tú la situación del traductor humano?
Sí, está clarísimo que ha sido una de las una de las profesiones más golpeadas de entrada por la erupción de la IA, porque la IA actual trabaja o ha trabajado fundamentalmente con generación de texto. Lo que ocurre es que el nivel de resistencia de los traductores humanos está dependiendo mucho de los tipos de texto con los que trabaje cada uno. Por ejemplo, tenemos tipos de documentos más estandarizados, como pueden ser los documentos contractuales, patentes, manuales de instrucciones y textos de este tipo, en los que ya desde hace tiempo se está trabajando mucho con post-edición, que es como nosotros llamamos a la reedición de un texto ya traducido por IA mediante un traductor o un lingüista experto.

Sin embargo, existen otros ámbitos creativos como la traducción literaria o la audiovisual, de películas y series, en los que un traductor humano todavía es garantía de calidad, porque la traducción automática comete muchos errores, precisamente por esa vinculación a la creatividad individual y al contexto en la que juegan un papel tan importante las nombres propios, y en estos tipos de textos aún más. Pensemos, por ejemplo, en los nombres propios inventados que contiene la literatura fantástica.
De todas maneras, yo pienso que, en un futuro próximo, todos los ámbitos de traducción van a converger en un trasvase de los roles del traductor al revisor humano. Incluso podemos hablar ya de evaluador.

Porque es verdad que nos encontramos con una paradoja muy interesante aquí, que es que cuanto más aumenta la calidad de los textos que traduce la máquina, eso no significa que los errores no aparezcan. Es decir, sigue habiendo errores, pero son muy sutiles y por lo tanto, por esa sutileza, la figura del humano vuelve a cobrar protagonismo, porque necesitamos a un experto que lo mire con lupa y con criterio para poder detectarlos.
Ahora la traducción se ha extendido a la sociedad, en general. Todos traducimos en casa, todos podemos traducir, hay páginas web que se traducen automáticamente. ¿De qué forma están cambiando los hábitos con respecto a la persona de a pie, de qué manera está cambiando la relación con las traducciones de diferentes idiomas?
Pues sí, yo hablaba anteriormente de paradojas, y aquí podemos a encontrar una paradoja, porque yo creo que la tecnología o el uso de esta, está llena de paradojas. Lo que pasa es que estaría en la dirección contraria. Es decir, nos encontramos con que cuanto más integradas están estas herramientas de traducción automática, como como tú comentabas, en páginas web o, por ejemplo, en las redes sociales, que cuentan con millones de usuarios a diario, la actividad de la traducción se vuelve más visible y más accesible incluso que cuando solo había traductores humanos.

Pensemos, por ejemplo, en un usuario común que no tenga ningún tipo de conocimiento lingüístico, solo el de su lengua materna, que emplee, por ejemplo, Instagram, la traducción automática de publicaciones de Instagram o el doblaje automático de YouTube, que ya está presente en muchas cuentas. Esta persona va a pulsar un botón de manera totalmente consciente para para hacer accesible esos contenidos en su idioma, y puede que incluso durante unos instantes te adopte el papel de un minitraductor, de un traductor temporal, ya que puede sentir curiosidad por la lengua de origen en el contexto de producción de esa publicación, aunque no la conozca, o si tiene un mínimo conocimiento de ambas lenguas, puede jugar a detectar algún fallo o a evaluar la calidad de esa traducción.
Entonces, es una, digamos, generalización de la actividad de traducción que aunque esté mermando el papel tradicional del traductor humano, al mismo tiempo está haciendo que la traducción sea una actividad de alguna manera cada vez más valorada por la sociedad en su conjunto.
Muy bien, yo creo que eso sería todo. Muchísimas gracias, Fernando, por tu tiempo y por toda la información.
Muchas gracias a vosotros, encantado de haber hablado con vosotros.
El trabajo de Fernando Sánchez se enmarca en el proyecto OP JAC "Becas MSCA en la Universidad Palacký IV", realizado en la Universidad Palacký de Olomouc, República Checa. Pueden ampliar la información en la pagina web oficial de Sánchez (https://fernandosanchezrodas.owlstown.net), así como su Instagram y Twitter académico (https://www.instagram.com/fsanchezrodas.phd, https://x.com/fsanchezrodas_).